
统一交易与分析:CedarDB如何应对AI智能体时代的数据挑战
打破传统界限,一站式数据库的崛起
长期以来,数据库领域存在一条泾渭分明的分界线:分析型数据库负责帮助企业洞察趋势、回答战略问题,而运营型数据库则专注于存储订单、支付等日常交易记录。然而,来自慕尼黑的数据库引擎CedarDB正在改变这一格局——它将两种能力合二为一,而这一设计思路在AI智能体蓬勃发展的当下显得尤为重要。
CedarDB的研发历程已逾十年,但其近期爆发的增长动力来自于企业用户的需求。许多公司的现有数据架构虽然能够妥善保存多年的交易记录,却在面对以自然语言提出的实时分析查询时力不从心。
从学术研究到商业落地的蜕变
CedarDB对分析型与运营型查询之间传统壁垒的质疑,源于其对效率的极致追求。作为慕尼黑工业大学的技术衍生项目,CedarDB植根于Umbra研究计划。该计划从零开始构建,旨在通过充分利用现代硬件性能来超越传统数据库引擎的处理速度。
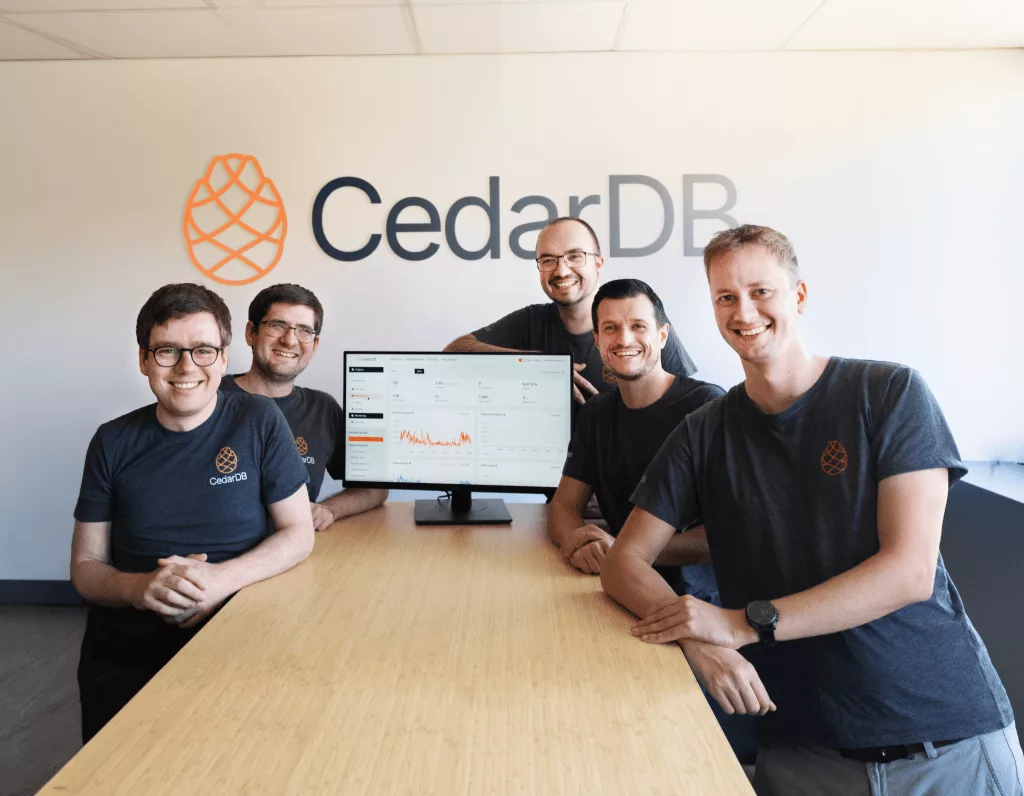
- CedarDB的核心团队由五名Umbra研究员联合创立
- 团队承诺在无需增加CPU算力或内存资源的前提下,实现更快的性能表现
- 对用户而言,迁移成本极低,只需少量改动即可适配
- 系统完全兼容PostgreSQL开源数据库,大幅降低使用门槛
选择PostgreSQL:一个明智的战略决策
据创始人兼首席执行官Moritz Sichert介绍,与流行数据库PostgreSQL保持兼容,意味着用户无需重新构建应用程序,从而将切换成本降至最低。这一选择还具有另一层战略意义:PostgreSQL的逻辑结构与大型语言模型在训练过程中所熟悉的内容高度契合。
Sichert表示,这一决策是众多看似”幸运”的选择之一,但背后并非偶然。联合创始人Christian Winter在一篇博客文章中详细记录了团队从学术界转向产业界后所确立的关键优先级,包括可靠性、容错能力以及与主流工具的兼容性。
产品发布与融资进展
团队在诸多关键问题上也曾激烈讨论。例如,是否应该立即推出云服务版本?最终,公司选择了稳健的策略:于去年五月同时推出CedarDB企业版(本地部署)和免费版的CedarDB社区版,并宣布完成530万欧元(约600万美元)的种子轮融资。
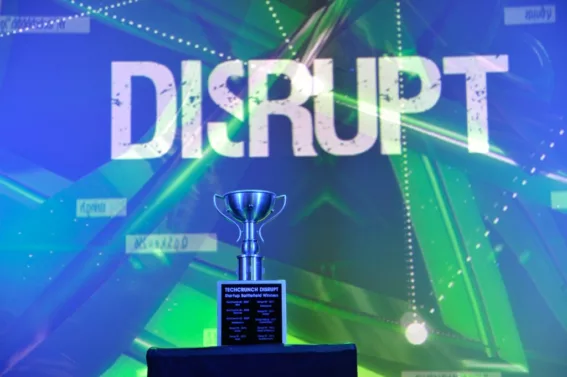
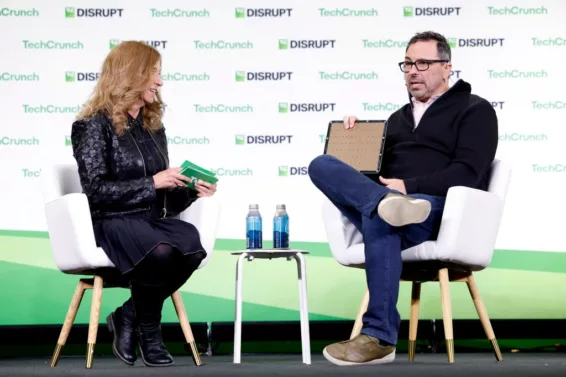
云服务并非被放弃,只是时间延后。经过对等待名单用户的内测验证,公司在TechCrunch Disrupt大会上正式宣布了CedarDB Cloud的有限公测。此刻,CedarDB正与另外20家创业公司同台竞技,角逐TechCrunch备受瞩目的Startup Battlefield大赛荣誉。
与Databricks的竞争与呼应
全托管的云托管版本有望帮助CedarDB突破大型企业的客户边界,进一步拓展用户群体。同时,这也使CedarDB更有底气应对Databricks等行业巨头的竞争——而这家美国数据巨头似乎得出了与这家德国初创公司相同的结论。
在今年六月的Data + AI峰会上,Databricks将”智能体时代”列为其推出LTAP新数据架构的主要原因。该架构旨在”在数据湖的单份存储之上,统一交易、分析、流处理和运营数据”。
Sichert认为,Databricks的动向进一步印证了市场对CedarDB所解决问题的高度需求。尽管尚难以预判其影响几何,但这无疑为行业指明了方向。
未来展望:团队扩张与下一轮融资
目前,CedarDB计划以现有的14人团队服务首批云用户。但Sichert坦言,随着用户基数的增长,团队规模必将扩大——而这也正是下一轮融资的契机。
从左至右依次为:CedarDB五位联合创始人Moritz Sichert、Lukas Vogel、Philipp Fent、Dominik Durner和Christian Winter。
关注微信号:智享开源 ,及时了解更新信息。


 公众号:智享开源
还没有任何评论,你来说两句吧!